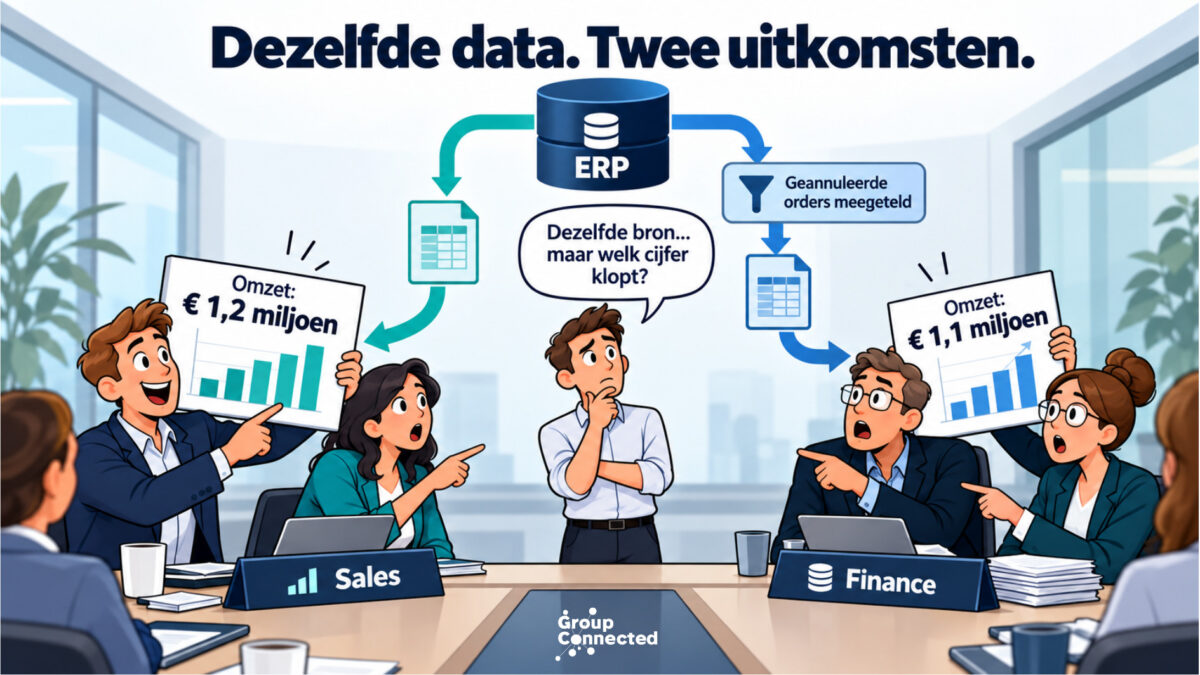
AI kan alleen betrouwbaar zijn als je weet waar je data vandaan komt.
Organisaties gebruiken steeds meer data voor dashboards, rapportages en AI-toepassingen. Maar hoe weet je of een uitkomst klopt? En waar begin je met zoeken als cijfers afwijken? Data lineage maakt de route van data zichtbaar: van de oorspronkelijke bron tot het moment waarop iemand de informatie gebruikt voor een beslissing. Dat klinkt technisch, maar het doel is praktisch: sneller fouten vinden, beter samenwerken en met meer vertrouwen beslissingen nemen.
Wat is data lineage?
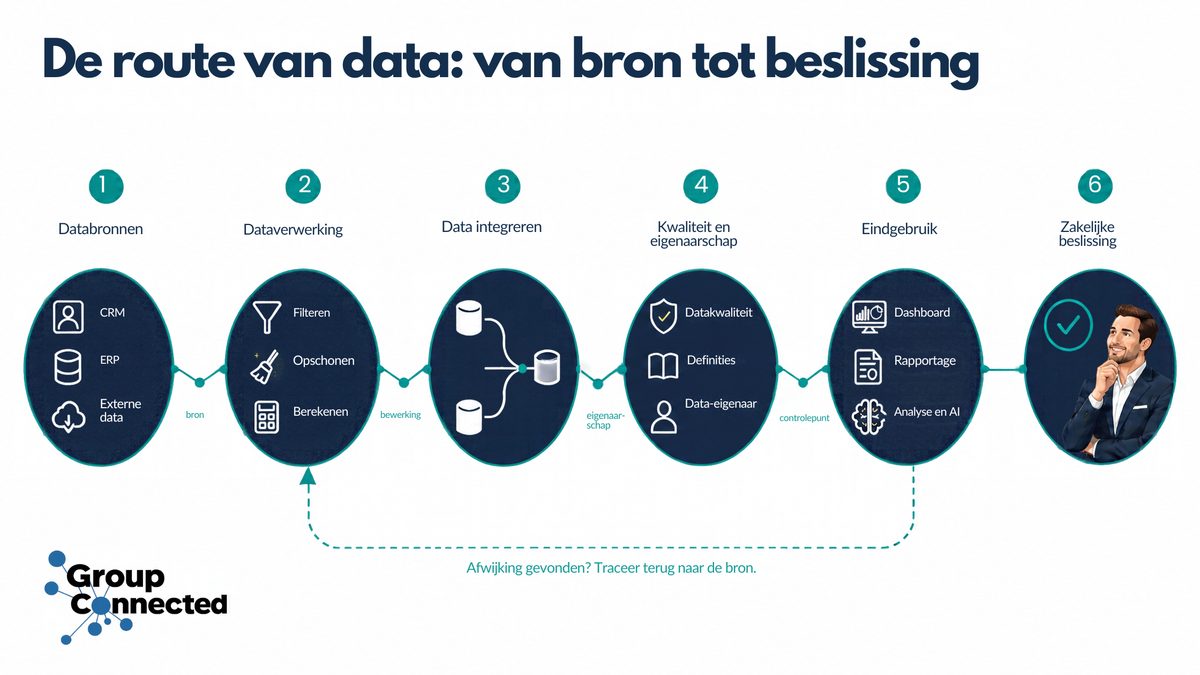
Data lineage is de vastgelegde reis van data door een organisatie. Het laat zien waar gegevens vandaan komen, welke bewerkingen zijn uitgevoerd, door welke systemen de data is gegaan en waar de uitkomst wordt gebruikt. Je kunt het vergelijken met een track-and-tracecode. Bij een pakket zie je waar het is verzonden, welke tussenstappen het heeft doorlopen en waar het is bezorgd. Data lineage doet hetzelfde voor gegevens.
Hoe werkt data lineage in de praktijk?
De route begint bij een bron, bijvoorbeeld een CRM-systeem, financiële administratie of externe databron. Daarna kan data worden samengevoegd, gefilterd of omgerekend. Iedere stap wordt vastgelegd in metadata: informatie over de data en de verwerking ervan. Moderne dataplatforms kunnen deze stappen vaak automatisch registreren. Zo ontstaat een visuele kaart van de datastroom. Wanneer een dashboard een onverwacht resultaat toont, kun je terugzoeken in welke bron of bewerking de afwijking is ontstaan. Verandert een bronsysteem? Dan zie je ook welke rapportages, modellen en AI-toepassingen daardoor geraakt kunnen worden.
Praktijkvoorbeeld: twee omzetcijfers
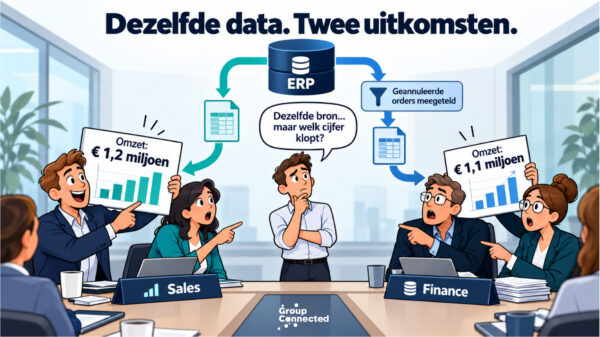
Een groothandel bespreekt de maandcijfers. Sales rapporteert € 1,2 miljoen omzet, terwijl Finance uitkomt op € 1,1 miljoen. Zonder data lineage gaan medewerkers handmatig exports, spreadsheets en definities vergelijken. Met data lineage wordt snel duidelijk dat het verkoopdashboard geannuleerde orders nog meetelt. De omzetgegevens komen uit hetzelfde ERP-systeem, maar zijn onderweg anders gefilterd. De organisatie kan de berekening herstellen én vastleggen welke definitie voortaan leidend is. Daarmee wordt niet alleen dit probleem opgelost, maar ook herhaling voorkomen.
Wat levert data lineage op?
De waarde zit niet alleen in techniek. Data lineage helpt de hele organisatie om beter met data te werken.
- Snellere foutopsporing: teams zien waar een afwijking is ontstaan en hoeven minder handmatig te zoeken.
- Meer vertrouwen in cijfers: gebruikers kunnen herleiden hoe een KPI of rapportage tot stand is gekomen.
- Duidelijker eigenaarschap: het wordt zichtbaar wie verantwoordelijk is voor een databron, definitie of verwerking.
- Betere impactanalyse: vóór een systeemwijziging is duidelijk welke rapportages en toepassingen worden geraakt.
- Betrouwbaardere AI: organisaties kunnen beoordelen welke data een model of AI-agent gebruikt en of die data geschikt is.
Welke rol speelt data lineage bij compliance?
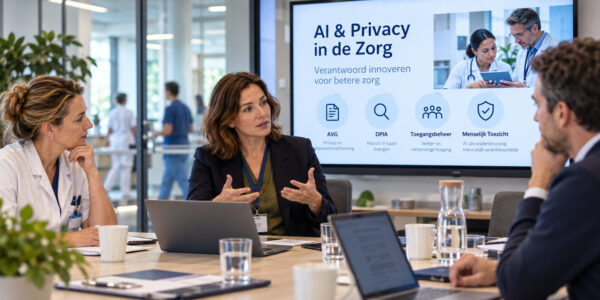
Organisaties moeten steeds vaker kunnen uitleggen welke gegevens zij gebruiken en hoe die worden verwerkt. Data lineage ondersteunt die aantoonbaarheid. Het helpt bijvoorbeeld bij privacyverzoeken, interne controles, audits en het beheersen van risico’s rond AI. Voor AI is dit extra belangrijk. Een model kan alleen betrouwbare uitkomsten geven als de onderliggende data betrouwbaar, actueel en herleidbaar is. Zonder zicht op de herkomst van data wordt het lastig om fouten uit te leggen of verantwoordelijkheid te nemen voor een uitkomst. Data lineage helpt ook om aan te tonen waar persoonsgegevens en andere gevoelige data vandaan komen, hoe ze worden verwerkt en waar ze worden gebruikt. Dat is relevant voor verplichtingen onder de AVG en voor organisaties die AI-systemen verantwoord en controleerbaar willen inzetten.
Wat is het verschil met een data catalogus?
Een data catalogus beschrijft welke datasets beschikbaar zijn, wat begrippen betekenen en wie de eigenaar is. Data lineage laat zien hoe die data door systemen en processen beweegt. Kort gezegd: de catalogus vertelt wat er is; data lineage vertelt hoe het daar is gekomen. Samen vormen ze een sterke basis voor datagovernance.
Welke tools kun je gebruiken?
Veel organisaties kunnen beginnen met de mogelijkheden die al in hun dataplatform aanwezig zijn. Werk je binnen een Microsoft-omgeving, dan kun je kijken naar de lineage- en governancefuncties binnen Microsoft Purview en Fabric. Organisaties met een Databricks-omgeving kunnen gebruikmaken van Unity Catalog. Ook in Snowflake-omgevingen kan data lineage onderdeel zijn van de bredere inrichting van data, metadata en governance. Welke oplossing past, hangt daarom vooral af van het bestaande platform en de manier waarop data door de organisatie stroomt. De beste keuze is niet automatisch de meest uitgebreide tool. Kijk eerst naar de belangrijkste datastromen, risico’s en vragen die je wilt beantwoorden. Soms is aanvullende governance-tooling nodig. In andere situaties zit de grootste winst juist in duidelijke definities, eigenaarschap en afspraken tussen teams.
Wanneer is investeren in data lineage verstandig?
Data lineage wordt relevant zodra meerdere systemen dezelfde cijfers voeden, teams verschillende definities gebruiken of fouten veel tijd kosten om te vinden. Ook bij de inzet van AI op interne data is het een belangrijk fundament. Een praktisch startpunt is één kritieke datastroom, bijvoorbeeld omzet, klantdata of een AI-toepassing. Breng de bron, bewerkingen, eigenaren en het eindgebruik in kaart. Zo wordt snel zichtbaar waar documentatie ontbreekt en waar de grootste risico’s zitten.
Grip op data als basis voor betrouwbare AI
Data lineage is geen doel op zich. Het is een manier om grip te krijgen op de data die beslissingen, processen en AI-toepassingen voedt. Dat sluit aan bij het Connect & Build-principe en het AI Foundation Model van GroupConnected: eerst zorgen voor een betrouwbaar fundament, daarna verantwoord opschalen. GroupConnected helpt organisaties om data, technologie, governance en mensen met elkaar te verbinden. Daarbij kunnen we expertise uit ons partnernetwerk koppelen aan de bestaande omgeving, bijvoorbeeld rond Microsoft Fabric en Purview, Databricks, Snowflake of de inrichting van datagovernance. Zo ontstaat geen los toolproject, maar een aanpak die past bij de organisatie en het gewenste resultaat.
Wil je weten waar jouw organisatie kan beginnen? Neem contact op met GroupConnected en ontdek hoe je data, governance en AI vanuit één stevig fundament organiseert.